






Resumen ejecutivo
En este informe se analiza el nivel de preparación para la recuperación ante desastres (DR) en la plataforma Acronis Cyber Platform (antes Acronis Cyber Protect Cloud), que gestiona miles de despliegues de DR en decenas de centros de datos de todo el mundo. El análisis se centra en el primer trimestre de 2026 (de enero a marzo) y pone de manifiesto una brecha clara entre disponer de una solución de recuperación ante desastres configurada y estar realmente preparado para afrontar un desastre real.
Los principales hallazgos son las siguientes:
- El 85 % de los servidores de recuperación no tienen activada la supervisión del objetivo de punto de recuperación (RPO), lo que implica que no existe ninguna comprobación automática que confirme si las copias de seguridad son lo suficientemente recientes.
- El 82 % de las reglas de procesadores de copia de seguridad carecen de una planificación de pruebas automatizada. Solo el 18 % ejecuta pruebas mensuales. En Acronis recomendamos realizar pruebas de conmutación por error cada seis meses.
- Las alertas relacionadas con VPN constituyen la familia de alertas más numerosa de la plataforma. En el primer trimestre de 2026 representaron el 35,4 % de todas las alertas de recuperación ante desastres —el grupo más amplio—, seguidas de los avisos sobre credenciales de copia de seguridad, con un 34,7 %.
En términos simples, muchas organizaciones han configurado la recuperación ante desastres, pero los datos muestran que una parte considerable de estas configuraciones nunca se ha puesto a prueba y presenta problemas de conectividad que podrían impedir que funcionaran durante una emergencia real.
El riesgo oculto en la recuperación ante desastres
Para los proveedores de servicios gestionados (MSP) y las pequeñas y medianas empresas (pymes), el nivel de riesgo sigue siendo especialmente elevado. Las investigaciones recientes muestran lo siguiente:
El mercado de soluciones de recuperación ante desastres alcanzó un valor de 23 550 millones de dólares en 2025 y se prevé que llegue a los 70 030 millones en 2029 (Research and Markets).
En una encuesta de Opengear y Digi, realizada en 2025, el 84 % de las empresas afirmó haber visto aumentar las interrupciones de red en los dos últimos años (Digi). El análisis de interrupciones de Uptime Institute de 2025 indica que el 16 % de las interrupciones ya supera el millón de dólares, mientras que el 54 % supera los 100 000 dólares (Uptime Institute).
FEMA informa de que aproximadamente el 25 % de las empresas termina cerrando definitivamente tras sufrir un desastre (FEMA).
Estas cifras apuntan a la misma conclusión: la recuperación ante desastres es una prioridad en aumento, las interrupciones siguen siendo costosas y frecuentes, y las pruebas rutinarias aún van a la zaga. En este informe se analiza si ese mismo patrón es visible en los datos reales de la plataforma.
El mercado de recuperación ante desastres para MSP y pymes presenta varias tendencias importantes que aportan contexto a nuestros hallazgos. Normativas como el RGPD, la ley HIPAA, la directiva NIS 2 y la ley DORA exigen cada vez más que las organizaciones documenten sus capacidades de recuperación y, en varios casos, que las prueben con regularidad. El RGPD exige medidas que garanticen la capacidad de restaurar la disponibilidad y el acceso a los datos personales en un plazo adecuado, así como un proceso para probar y evaluar periódicamente los controles de seguridad. La ley HIPAA exige a las entidades cubiertas y a los asociados comerciales mantener planes de contingencia, incluido un plan de recuperación ante desastres y procedimientos de prueba y revisión periódicos. La directiva NIS 2 incluye explícitamente la gestión de copias de seguridad, la recuperación ante desastres y la gestión de crisis entre las medidas obligatorias de gestión de riesgos de ciberseguridad. La ley DORA va más allá en el caso de las entidades financieras al exigir continuidad operativa de las TIC, procedimientos de copia de seguridad, restauración y recuperación, así como pruebas anuales de los planes de continuidad operativa de las TIC y de los planes de respuesta y recuperación de las TIC. Para los MSP que prestan servicio a clientes regulados, esto eleva los requisitos de cumplimiento normativo y las obligaciones contractuales cuando los controles de recuperación no se mantienen ni se prueban.
Los datos sobre el nivel de preparación de la recuperación ante desastres también apuntan a una brecha similar entre confianza y ejecución. Una encuesta de la U.S. Chamber of Commerce Foundation de 2024 reveló que, aunque el 94 % de los directivos de pymes creía que su empresa se recuperaría de un desastre, solo el 26 % disponía de un plan real de recuperación ante desastres. El informe de 2025 del Business Continuity Institute también reveló que los responsables de continuidad operativa están prestando más atención a las pruebas de las estrategias de respuesta y recuperación, lo que refuerza que la validación operativa sigue siendo un aspecto central. Este patrón coincide con lo que observamos en los datos de nuestra plataforma.
La transición desde la recuperación in situ hacia la recuperación basada en la nube también continúa. MarketsandMarkets prevé que el mercado global de recuperación ante desastres como servicio (DRaaS) crecerá de 16 100 millones de dólares en 2025 a 46 100 millones de dólares en 2032, con una tasa de crecimiento anual compuesta (TCAC) del 16,2 %. Los segmentos de MSP y pymes, que son el principal foco de Acronis, son menores en tamaño absoluto, pero se espera que crezcan a un ritmo similar. En otras palabras, cada vez más empresas despliegan infraestructura de recuperación ante desastres, aunque una adopción más amplia no implica automáticamente una mayor frecuencia de pruebas.
La supervisión del RPO está desactivada en gran medida
El objetivo de punto de recuperación (RPO) define la cantidad máxima aceptable de pérdida de datos medida en tiempo. Por ejemplo, un RPO de 15 minutos significa que, en el peor desastre posible, la empresa puede permitirse perder como máximo 15 minutos de datos. La supervisión del RPO es el mecanismo que comprueba de forma activa si las copias de seguridad se realizan con la frecuencia necesaria para cumplir ese objetivo. Cuando la supervisión del RPO está activada, el sistema genera una alerta si la copia de seguridad más reciente de un servidor de recuperación tiene una antigüedad superior al umbral configurado. Cuando está desactivada, no se genera ninguna alerta, incluso si las copias de seguridad han dejado de realizarse por completo.
Para un MSP que gestiona decenas o cientos de entornos de clientes, la supervisión del RPO es una de las herramientas proactivas más importantes disponibles. Sin ella, el MSP no dispone de ningún mecanismo automatizado que le permita saber que la protección de recuperación ante desastres de un cliente se ha degradado. El problema puede aflorar únicamente durante la conmutación por error, cuando el cliente descubre que su punto de recuperación más reciente tiene varios días o incluso semanas de antigüedad. Para entonces, el daño ya está hecho.
Lo que muestran los datos
Nuestro análisis indica que el 85 % de todos los servidores de recuperación de la plataforma tienen la supervisión del RPO completamente desactivada. Esto significa que, para la gran mayoría de las cargas de trabajo protegidas, no existe ninguna verificación automatizada que confirme que las copias de seguridad se están realizando a tiempo.
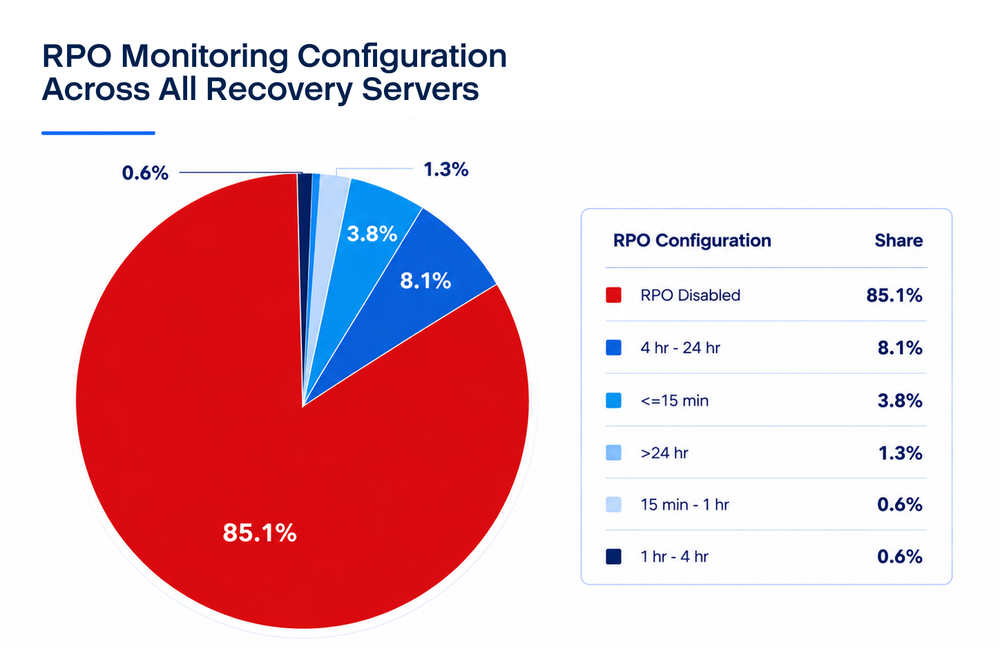
Entre el 15 % de servidores que sí tienen la supervisión del RPO activada, la configuración más habitual se sitúa en el intervalo de entre cuatro y 24 horas. Se trata de una elección pragmática para muchas cargas de trabajo de pymes, en las que el coste de realizar copias de seguridad muy frecuentes (en términos de almacenamiento y ancho de banda) supera el riesgo de perder unas pocas horas de datos. Sin embargo, incluso este grupo representa una fracción muy pequeña del total.
La cuestión que plantean estos datos no es si todos los servidores necesitan un RPO de 15 minutos —sería irreal e innecesario para muchas cargas de trabajo—. La cuestión es si no disponer de supervisión alguna es una decisión intencionada o simplemente un valor predeterminado que nunca se cambió.
Hay una diferencia importante entre optar por no supervisar el RPO porque la carga de trabajo no lo requiere y no hacerlo simplemente porque nadie lo activó durante la configuración. La plataforma se basa en valores predeterminados para la supervisión del RPO configurada por el usuario, lo que significa que cada servidor parte de la configuración inicial definida por el administrador. Dado que la inmensa mayoría nunca sale de ese estado, todo apunta a que gran parte de los flujos de trabajo de configuración no incluyen la definición del RPO como un paso estándar.
El riesgo para los MSP
Para los MSP, este hallazgo tiene implicaciones directas para el negocio. Cuando un MSP vende protección de recuperación ante desastres a un cliente, el cliente espera que sus datos puedan recuperarse hasta un momento dado. Si las copias de seguridad dejan de ejecutarse sin generar alertas —por un problema de red, un fallo del agente, un error de almacenamiento o simplemente una mala configuración— y la supervisión del RPO no está activada, el MSP no detectará el problema hasta que el cliente necesite recuperar datos.
Esto genera una situación en la que el MSP queda expuesto a un riesgo que no puede ver. El cliente contrata un servicio de protección, y el MSP cree que la protección está en funcionamiento, pero en realidad la última copia de seguridad correcta puede tener varios días de antigüedad. En sectores regulados, esto puede derivar en incumplimientos normativos, y en cualquier otro sector, se traduce en pérdida de datos y en una merma de la confianza de los clientes.
La solución es sencilla: activar la supervisión del RPO con un umbral predeterminado razonable durante la configuración inicial de la recuperación ante desastres. Un umbral de 24 horas es un punto de partida adecuado para la mayoría de las cargas de trabajo: permite detectar casos en los que las copias de seguridad han dejado de ejecutarse por completo sin generar ruido excesivo en aquellas cargas de trabajo que sí disponen de copias de seguridad diarias.
Las pruebas automatizadas siguen siendo la excepción
Si hay una lección que el sector de TI ha aprendido tras décadas de recuperación ante desastres, es esta: un plan de recuperación que no se ha sometido a ninguna prueba no es un plan en absoluto. Las desviaciones en la configuración, las actualizaciones de software, los cambios de hardware, las reconfiguraciones de red y los simples errores humanos pueden introducir fallos invisibles en la cadena de recuperación ante desastres. La única forma de verificar que toda la cadena funciona —desde la copia de seguridad hasta el punto de recuperación, el arranque de la máquina virtual y la conectividad de red— es probarla de extremo a extremo.
La plataforma de Acronis admite dos tipos de pruebas automatizadas. Las pruebas automatizadas mensuales ejecutan una conmutación por error de prueba planificada una vez al mes, arrancan los servidores de recuperación en una red de pruebas aislada, verifican que arranquen correctamente y, opcionalmente, ejecutan comprobaciones de estado personalizadas. Las pruebas semanales hacen lo mismo, pero con mayor frecuencia. Ambas opciones están diseñadas para ejecutarse sin necesidad de intervenir manualmente y sin afectar al entorno de producción.
A pesar de la disponibilidad de estas funciones, los datos muestran una realidad muy distinta en cuanto a su adopción real.
Lo que muestran los datos
Nada menos que el 82 % de las reglas activas del procesador de copias de seguridad en la plataforma tienen su planificación de pruebas automatizadas establecida en "NUNCA". Solo el 18 % de las reglas están configuradas para realizar pruebas mensuales, y apenas un 0,2 % utilizan pruebas semanales. Esto significa que, para la inmensa mayoría de las cargas de trabajo con protección de recuperación ante desastres, no existe ninguna verificación automatizada de que el proceso de recuperación funcione realmente.

Para poner estos datos en perspectiva: si un MSP gestiona 100 cargas de trabajo con protección de recuperación ante desastres y utiliza los valores predeterminados de la plataforma, aproximadamente 82 de esas cargas de trabajo nunca se han sometido a una prueba de conmutación por error automatizada. En la práctica, el MSP está apostando a que todas funcionarán cuando sea necesario, una apuesta hecha sin fundamento alguno.
Conmutaciones por error de prueba vs. de producción
Al analizar la actividad real de conmutación por error durante el primer trimestre de 2026, FAILOVER_PROD representó alrededor del 40 % de todos los eventos de conmutación por error en la plataforma, pero la mayoría de estos eventos fueron muy breves y, operativamente, correspondían a ejercicios de prueba. Para aislar los desastres genuinos, limitamos la vista a las conmutaciones por error que duraron más de 24 horas, una duración coherente con un escenario de recuperación real y no con una verificación rápida o un ensayo de conmutación tras recuperación.

Como resultado, solo el 0,75 % de los eventos FAILOVER_PROD duraron más de 24 horas; alrededor del 97 % se completaron en menos de una hora —eventos que se asemejan a ejercicios breves de conmutación por error y conmutación tras recuperación, verificaciones ad hoc o conmutaciones por error iniciadas en modo de producción y revertidas casi de inmediato—. El mismo patrón se observa en las conmutaciones por error de prueba manuales (1,7 % duraron más de 24 horas) y es aún más extremo en las pruebas automatizadas (≈0,004 %). Si se agregan los tres estados, menos del 1 % de los eventos de conmutación por error en la plataforma durante el primer trimestre de 2026 duraron lo suficiente como para parecer un escenario de recuperación real.
La cifra más relevante es la proporción de la plataforma realmente afectada: menos del 0,15 % de los servidores de recuperación experimentaron un evento sostenido de recuperación real durante todo el trimestre, e incluso dentro del conjunto de máquinas virtuales que tuvieron algún contacto con FAILOVER_PROD en el primer trimestre, solo alrededor del 25 % registró un evento que duró más de 24 horas.
Cuando estos pocos desastres reales afectan a cargas de trabajo que nunca se han sometido a pruebas, la recuperación se convierte en un experimento realizado por primera vez y bajo presión.
El coste de no realizar pruebas
Los datos del sector sobre este tema son claros. Las organizaciones que prueban sus capacidades de recuperación ante desastres con regularidad registran tiempos de recuperación significativamente más cortos y tasas de éxito mucho más altas que aquellas que no lo hacen. Un estudio de 2024 del Disaster Recovery Preparedness Council concluyó que las organizaciones que probaban sus capacidades de recuperación ante desastres mensualmente alcanzaron una tasa de éxito del 92 % en la recuperación al primer intento, frente al 54 % de aquellas que realizaban pruebas una vez al año o con menor frecuencia.
Para los MSP, el cálculo es simple. El coste de ejecutar una prueba automatizada mensual es mínimo: la plataforma la gestiona de forma automática y utiliza redes de prueba aisladas que no afectan al entorno de producción. Por otro lado, el coste de una recuperación fallida durante un desastre real puede ser catastrófico: pérdida de datos de clientes, penalizaciones por infringir los acuerdos de nivel de servicio (SLA), daños reputacionales y, en algunos casos, responsabilidad legal en virtud de la normativa de protección de datos.
Consideramos que la baja tasa de adopción de pruebas se debe principalmente a la configuración, más que a una decisión deliberada por parte de los MSP. Cuando se configura la recuperación ante desastres, las pruebas son opcionales y, por defecto, están desactivadas. En los entornos de MSP con mucha actividad, donde la incorporación de un nuevo cliente implica muchos pasos, la configuración de las pruebas se pasa por alto con facilidad.
Los patrones de alertas revelan problemas sistémicos
Cada alerta relacionada con la recuperación ante desastres generada por la plataforma indica que algún elemento del entorno de recuperación ante desastres requiere atención. Algunas alertas son informativas; por ejemplo, notifican que una operación de conmutación tras recuperación se ha completado correctamente. Otras son avisos críticos de que ha fallado un componente clave. Al analizar la distribución y las tendencias de estas alertas, es posible obtener una visión del estado general del entorno de recuperación ante desastres e identificar problemas sistémicos que afectan simultáneamente a numerosos clientes.
Principales tipos de alertas en el primer trimestre de 2026
El gráfico siguiente muestra los 10 tipos de alerta de recuperación ante desastres más frecuentes durante el primer trimestre de 2026, medidos como porcentaje del total de alertas de recuperación ante desastres:
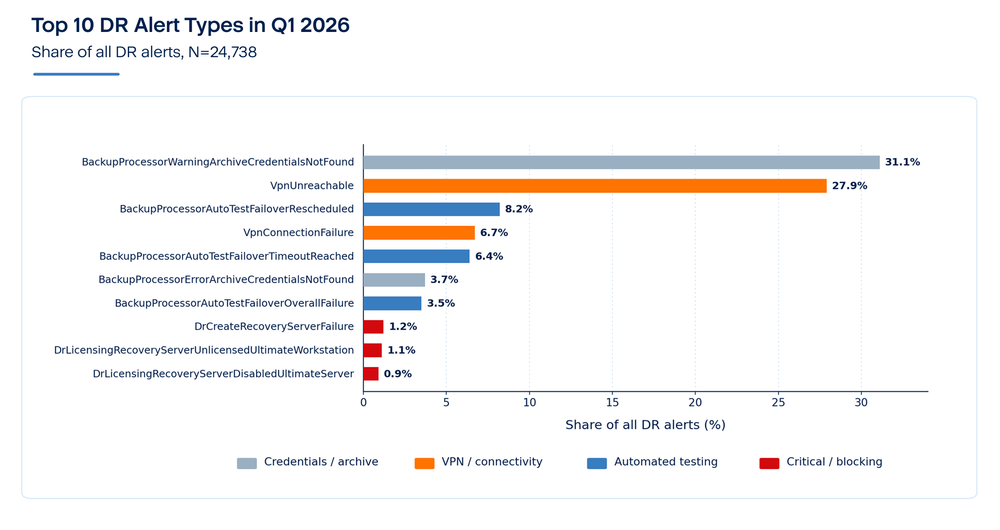
Varios patrones resultan evidentes de inmediato. Las alertas relacionadas con VPN (VpnUnreachable, VpnConnectionFailure) dominan el panorama de alertas, lo que confirma los problemas de conectividad mencionados en la sección anterior. No se trata de eventos aislados: representan problemas persistentes y recurrentes que afectan cada mes a un número significativo de despliegues.
El segundo grupo de alertas destacadas está relacionado con fallos en las pruebas automatizadas. BackupProcessorAutoTestFailoverTimeoutReached y BackupProcessorAutoTestFailoverOverallFailure indican que, incluso dentro de la minoría de cargas de trabajo que sí tienen habilitadas las pruebas automatizadas, un porcentaje considerable de esas pruebas está fallando. Esto significa que la población realmente "operativa y probada" es aún menor que el 18 % que tiene la función de pruebas configurada.
La alerta DRPolicyFailedCreateRecoveryServer (de gravedad crítica) indica casos en los que el sistema no pudo crear un servidor de recuperación en absoluto. Se trata del tipo más grave de fallo de preparación: no solo no se ha probado la recuperación ante desastres, sino que la infraestructura básica necesaria para la recuperación ni siquiera existe. En Acronis, esto se supervisa de forma continua por el equipo de I+D y cada fallo se investiga individualmente.
Tasas de error en tareas
Para complementar los datos de alertas, también analizamos los resultados de ejecución de tareas de recuperación ante desastres durante el primer trimestre de 2026. Las tareas representan operaciones específicas que ejecuta la plataforma (copias de seguridad, conmutación por error, creación de servidores de recuperación, etc.) y cada tarea tiene un resultado de éxito o de fallo:
Consulta: SELECT type, result_code, count(*) as cnt FROM tasks WHERE type LIKE 'dr_%' AND created_at >= '2026-01-01' AND created_at < '2026-04-01' GROUP BY type, result_code ORDER BY cnt DESC
Dos tipos de tareas dominan el volumen total de errores de recuperación ante desastres en el primer trimestre de 2026: dr_failback_data_transfer_resume (252 929 errores, el 46,8 % de todos los errores de recuperación ante desastres) y dr_delete_tenant (251 173 errores, el 46,4 % del total). Ambas representan aproximadamente el 93 % de los 540 909 errores de tareas de recuperación ante desastres registrados durante el trimestre. Más allá de estos dos tipos de tareas, los 43 tipos restantes con errores aportan en conjunto el 6,8 % de los errores de recuperación ante desastres. Para los MSP, la implicación práctica es que los flujos de conmutación tras recuperación y eliminación de inquilinos deben investigarse como las principales fuentes de errores, mientras que las operaciones rutinarias —como la conmutación por error, el arranque y la conmutación por error en modo de prueba— deben seguir supervisándose para comprobar su correcta finalización.
Tendencias de gravedad a lo largo del tiempo
La combinación de niveles de gravedad de las alertas de recuperación ante desastres se ha mantenido relativamente estable durante los últimos seis meses:
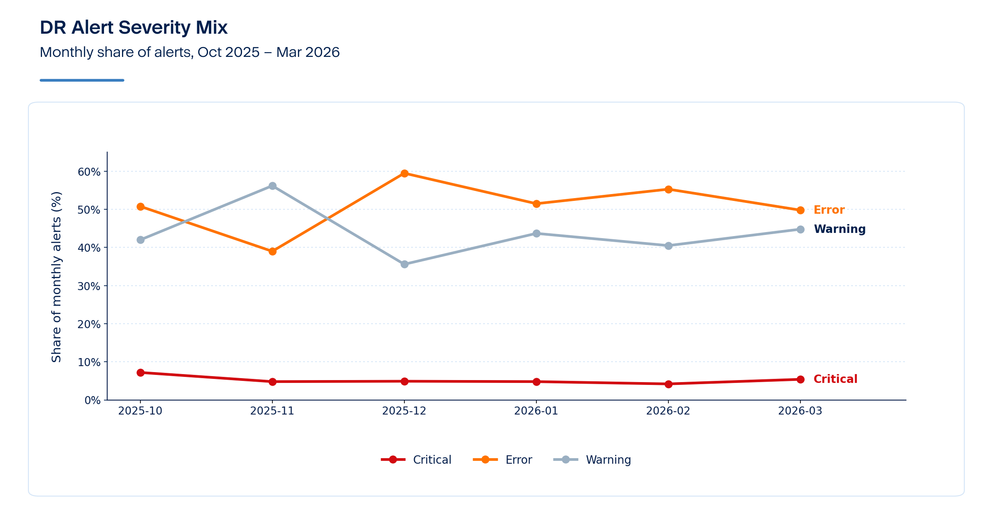
La coherencia de este patrón es, en sí misma, informativa. Una distribución de gravedad estable indica que los problemas subyacentes no están empeorando, pero tampoco están mejorando. Los mismos tipos de incidencias —desconexiones de VPN, fallos de pruebas o fallos en la creación de servidores— se repiten mes tras mes con una frecuencia similar. Esto apunta a causas estructurales (configuraciones predeterminadas, puntos ciegos operativos) más que a incidentes aislados o patrones estacionales.
Para los equipos de producto, esta estabilidad representa una oportunidad. Dado que los problemas son previsibles y recurrentes, las intervenciones específicas (mejores valores predeterminados, alertas proactivas y cambios en el proceso de incorporación) probablemente tendrán un impacto medible y duradero. Para los MSP, la naturaleza estable de estas alertas implica que pueden abordarse mediante procesos de revisión sistemáticos en lugar de recurrir a acciones reactivas.
El crecimiento supera a la preparación
Para integrar los resultados, elaboramos un indicador compuesto de preparación basado en estas dimensiones: supervisión del RPO (¿está habilitada?), pruebas automatizadas (¿están planificadas?) y conectividad VPN (¿está activo el túnel?). Cada dimensión es binaria: un servidor o un despliegue cumple el umbral mínimo o no lo cumple.
Esta tabla muestra que, en las tres dimensiones de preparación, el grupo "no preparado" es significativamente mayor que el grupo "preparado". Aunque estas dimensiones se miden de forma independiente (un único despliegue puede estar bien configurado en un área y mal configurado en otra), el panorama general indica que la preparación es la excepción y no la norma.
Los riesgos mencionados se acumulan. Pensemos en un escenario en el que el servidor de producción de un cliente falla y necesita realizar una conmutación por error hacia la nube. Si la supervisión del RPO está deshabilitada, es posible que el cliente no sepa que su punto de recuperación más reciente tiene tres días en lugar de tres horas. Si las pruebas automatizadas nunca se configuraron, nadie sabe si el servidor de recuperación arrancará y funcionará correctamente.
Cada brecha individual reduce la probabilidad de llevar a cabo un proceso de recuperación satisfactorio. Cuando varias brechas coinciden, la probabilidad disminuye aún más.
Qué significa esto para el mercado
La brecha entre el despliegue y la preparación no es exclusiva de una plataforma o proveedor concreto. Refleja un patrón más amplio en el sector, en el que la urgencia por "disponer de recuperación ante desastres" (impulsada por las ventas, el cumplimiento normativo o el miedo) supera la disciplina de "mantener la recuperación ante desastres en perfecto funcionamiento" (lo cual exige esfuerzo continuo, pruebas y atención). A medida que el mercado de recuperación ante desastres sigue creciendo, es probable que la brecha en el nivel de preparación se amplíe, a menos que el sector convierta las mejores prácticas de preparación en estándares automáticos y predeterminados, en lugar de considerarlas como algo opcional y manual.
Los MSP están en una posición única para abordar esta brecha porque gestionan la recuperación ante desastres en nombre de sus clientes. Un solo MSP que mejore sus procesos de incorporación y supervisión puede mejorar el nivel de preparación de cientos o miles de cargas de trabajo de clientes finales. Ahí es donde el efecto multiplicador es mayor y donde se centran las recomendaciones de la siguiente sección.
Conclusión y recomendaciones
Este análisis de la telemetría de Acronis correspondiente a los datos de la plataforma del primer trimestre de 2026 revela una brecha significativa entre el despliegue de recuperación ante desastres y el nivel real de preparación para la recuperación. Aunque el número de organizaciones que utilizan funciones de recuperación ante desastres sigue creciendo con rapidez, los datos muestran que la mayoría de estos despliegues presentan problemas fundamentales de preparación que podrían impedir que funcionen durante un desastre real.
Las dos áreas principales que más preocupan son las siguientes:
- Supervisión del RPO: el 85 % de los servidores de recuperación no tienen configurada la supervisión del RPO. Esto significa que, si las copias de seguridad dejan de ejecutarse o se retrasan respecto al calendario previsto, nadie recibe una alerta automáticamente. Para las empresas que dependen de la recuperación ante desastres para protegerse frente a la pérdida de datos, esto equivale a tener un detector de humo sin batería: el dispositivo está instalado, pero no le avisará cuando haya un incendio.
La magnitud de esta cifra sugiere que se trata de un problema de configuración por defecto y no de una decisión deliberada. Activar la supervisión del RPO de forma predeterminada, con un umbral razonable de 24 horas, cerraría de inmediato esta brecha en todos los nuevos despliegues y debería considerarse un cambio de producto de alta prioridad.
- Pruebas automatizadas: el 82 % de las reglas de copia de seguridad para la recuperación ante desastres no tienen ninguna prueba automatizada planificada. Las mejores prácticas del sector recomiendan realizar pruebas de recuperación ante desastres al menos una vez al mes; sin embargo, solo el 18 % de las reglas cumplen con esa premisa, y menos del 0,2 % realizan pruebas semanales. Sin pruebas periódicas, los errores de configuración, las actualizaciones de software y los cambios en la infraestructura pueden romper silenciosamente la cadena de recuperación ante desastres.
La primera vez que muchas organizaciones descubren que sus funciones de recuperación ante desastres no funcionan es durante un desastre real, el peor momento posible para darse cuenta. Además, incluso entre las cargas de trabajo que sí tienen activadas las pruebas automatizadas, un porcentaje significativo de esas pruebas falla, como muestran las alertas de fallos sobre pruebas automatizadas. Esto significa que la población realmente "operativa y probada" es aún menor. La combinación de una adopción insuficiente de la función de pruebas automatizadas y una tasa de fallos significativa crea una situación en la que la confianza en el nivel de preparación debería ser mucho menor de lo que suele ser.
El impacto en el negocio
Para los MSP que gestionan la recuperación ante desastres de sus clientes, estos resultados representan tanto un riesgo como una oportunidad. El riesgo es evidente: un MSP cuyos clientes sufran un desastre y descubran que su recuperación ante desastres no funciona se expone a daños reputacionales, posibles responsabilidades legales y, por supuesto, a la pérdida de dichos clientes. En sectores regulados, las consecuencias pueden incluir sanciones y medidas de cumplimiento que afecten tanto al MSP como al cliente final.
La oportunidad es igual de clara: los MSP que identifiquen y corrijan de forma proactiva las brechas en la preparación pueden diferenciarse mediante una fiabilidad demostrada. Un MSP que pueda mostrar a un cliente un informe mensual con pruebas de conmutación por error satisfactorias, conexiones VPN activas y cumplimiento del RPO aporta un valor tangible y verificable. En un mercado competitivo en el que muchos MSP ofrecen servicios similares a precios parecidos, poder demostrar a sus clientes de forma clara su nivel de preparación se convierte en un poderoso diferenciador.
Para las pymes, el mensaje es simple: tener la recuperación ante desastres configurada no equivale a estar protegido. Una configuración de recuperación ante desastres que nunca se ha puesto a prueba y que presenta problemas de conectividad VPN genera una falsa sensación de seguridad que puede resultar costosa en un incidente real. La pregunta adecuada que debe plantearle a su MSP no es "¿Tengo recuperación ante desastres?", sino "¿Cuándo se probó por última vez mi recuperación ante desastres y cuál fue el resultado?".
Recomendaciones para MSP y proveedores de servicios
- Active la supervisión del RPO en todos los servidores de recuperación, con umbrales apropiados según el SLA de cada cliente. La plataforma admite esa función de forma nativa; tan solo hay que activarla. Un umbral de 24 horas es un punto de partida seguro para la mayoría de las cargas de trabajo.
- Configure pruebas automatizadas de conmutación por error al menos una vez al mes para todas las cargas de trabajo protegidas mediante recuperación ante desastres. Este es el cambio más determinante que los MSP pueden introducir para mejorar el nivel de preparación para la recuperación ante desastres. Revise los resultados de las pruebas cada mes y realice un seguimiento de los fallos.
- Revise periódicamente el estado de los túneles VPN y considere migrar, siempre que sea posible, los despliegues basados en routers de cliente al modo de dispositivo VPN, ya que los datos muestran tasas de conectividad significativamente mejores.
- Cree paneles de control de preparación para la recuperación ante desastres que permitan supervisar el cumplimiento del RPO, las tasas de éxito de las pruebas y la conectividad VPN en todos los clientes administrados. Utilice estos paneles de control en las revisiones empresariales trimestrales con los clientes.
- Incluya los resultados de las pruebas de recuperación ante desastres en los informes periódicos al cliente para generar confianza y demostrar valor. Un cliente que ve pruebas mensuales de que su recuperación ante desastres funciona es un cliente que renueva su contrato con usted.
- Considere habilitar la supervisión del RPO por defecto en los nuevos servidores de recuperación, con un umbral predeterminado razonable (por ejemplo, 24 horas). Para las funciones de seguridad, es preferible el modelo de exclusión voluntaria al de inclusión voluntaria.
- Añada una "puntuación de preparación para la recuperación ante desastres" a la consola de administración que combine la supervisión del RPO, las pruebas automatizadas y el estado de la conectividad en una única métrica fácil de interpretar. Muéstrela de forma destacada en el panel de control.
- Implemente notificaciones automáticas cuando los túneles VPN lleven más de 24 horas desconectados. Asegúrese de que estas alertas no pasen desapercibidas.
- Proporcione un proceso de incorporación guiado que incluya la configuración de las pruebas automatizadas de conmutación por error como un paso obligatorio, no como algo opcional. Acompañe a los MSP en la configuración de las pruebas durante el despliegue inicial de la recuperación ante desastres.
- Cree plantillas de informes que ayuden a los MSP a comunicar a sus clientes el estado de preparación para la recuperación ante desastres en un lenguaje claro y sin tecnicismos.
Si usted es un cliente final (pyme): pídale a su MSP pruebas de que su recuperación ante desastres se ha probado recientemente. Una pregunta tan sencilla como "¿Cuándo fue la última prueba de conmutación por error satisfactoria?" puede revelar mucha información sobre su nivel real de protección. Comprenda sus objetivos de punto de recuperación (RPO) y de tiempo de recuperación (RTO) y verifique que se ajustan a las necesidades de su negocio. Los valores predeterminados pueden no ser adecuados para sus requisitos específicos. Si su empresa opera en un sector regulado, asegúrese de que la frecuencia de las pruebas de recuperación ante desastres cumple los requisitos normativos. Muchas regulaciones exigen ahora documentación que acredite que dichas pruebas se lleven a cabo de forma periódica.